

Meta visitera votre site, même sans votre accord explicite
Le 20 novembre, trois semaines plus tard que prévu, Meta change ses conditions pour les annonceurs. Nous avons comparé six versions : certaines ne disent pas tout à fait la même chose.
Par Jhovany Mabiala
CEO, EMA DigitalPublié le Mis à jour le
Mise à jour du 27 octobre : Meta a repoussé l’entrée en vigueur de ses conditions du 30 octobre au 20 novembre 2026 ; les dates sont corrigées. La clause d’exploration n’a pas changé, robots.txt n’y figure toujours pas. La lecture des six versions (19 et 21 octobre) est conservée, non refaite. Mise à jour du 21 octobre : relevé daté des six versions de l’aperçu des conditions de Meta, désormais toutes corrigées (le français, l’allemand et l’italien disaient « entraîner » le 19 octobre). Les lectures du 19 octobre sont conservées ; le reste du texte est inchangé.

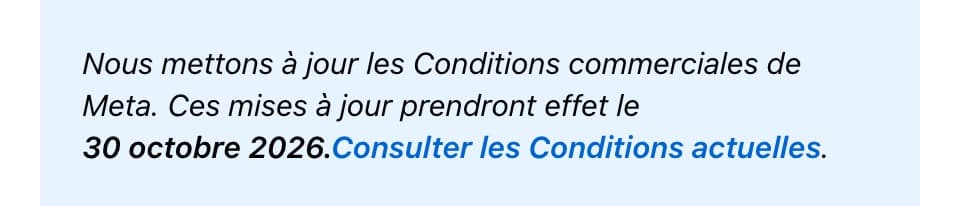
Une boutique de vêtements fait de la publicité sur Instagram, et chaque annonce renvoie vers les fiches produits de son site. Si elle continue à utiliser ses outils Meta après le 20 novembre, elle aura accepté que les robots de Meta lisent ce site, en gardent une copie et en reprennent les mises à jour.
Meta assure que rien ne change pour ses robots. Nous avons lu le texte lui-même, ses différentes versions et la documentation de Meta : voici ce qu’il permet vraiment, et ce que vous pouvez décider avant l’échéance.
La clause figure dans les nouvelles conditions commerciales de Meta, celles qui s’appliquent dès qu’on utilise ses produits « à des fins professionnelles ou commerciales ».
- Qui est concerné
- Toute entreprise ou personne qui utilise Facebook, Instagram, WhatsApp ou Messenger à des fins professionnelles : publicité, boutique, catalogue, Page ou Meta Business Suite.
- Ce que cela change pour votre entreprise
- Le site vers lequel renvoient vos annonces, votre catalogue ou votre Page entre dans le périmètre que Meta peut parcourir, sans option de retrait.
- Que faire
- Listez vos comptes professionnels et les domaines qui y sont liés, puis décidez, robot par robot, ce que votre fichier robots.txt autorise avant le 20 novembre.
Réponse courteLa réponse en quelques lignes
Dès le 20 novembre 2026 (Meta a repoussé la date du 30 octobre), une entreprise qui utilise Facebook, Instagram ou WhatsApp pour son activité autorise Meta à parcourir les sites liés à ses produits et à en utiliser le contenu pour ses services. Il n’y a pas de refus partiel : refuser, c’est arrêter les outils professionnels de Meta.
SommaireCe que la clause autorise, mot pour mot
Ce que la clause autorise, mot pour mot
Le texte est large. Vous autorisez Meta à utiliser « des extracteurs de données Web, des bots, des robots » et à « créer des identifiants de test » pour accéder aux pages « associés à vos produits ou services », les mettre en cache, les analyser et en reprendre « périodiquement » les mises à jour.
Le périmètre aussi : publicité, vente, catalogue, Page ou Meta Business Suite, « quel que soit le type d’entité ». Et il n’existe pas de retrait partiel : qui refuse doit « cesser tout accès ou utilisation » professionnelle des produits de Meta.
Ce n’est pas tout à fait nouveau. Selon Nieman Lab, une permission proche existait déjà, limitée aux outils d’IA générative pour les publicités et destinée à « optimiser vos publicités ». Les conditions en vigueur avant ces nouvelles conditions n’en disent rien.
Meta a corrigé sa clause, en partie
Le 15 octobre, Nieman Lab a publié l’analyse de trois juristes : lu au pied de la lettre, le texte permettrait à Meta d’entraîner son IA sur le contenu des sites d’éditeurs de presse. Deux jours plus tard, selon le même média, Meta a retiré « train » et limité les usages aux « produits publicitaires et professionnels ».
Le 19 octobre, nous avons ouvert l’aperçu des conditions dans six versions, depuis une connexion en Suisse, à 10 h 35, à 15 h 40 et à 22 h 18, heure UTC.
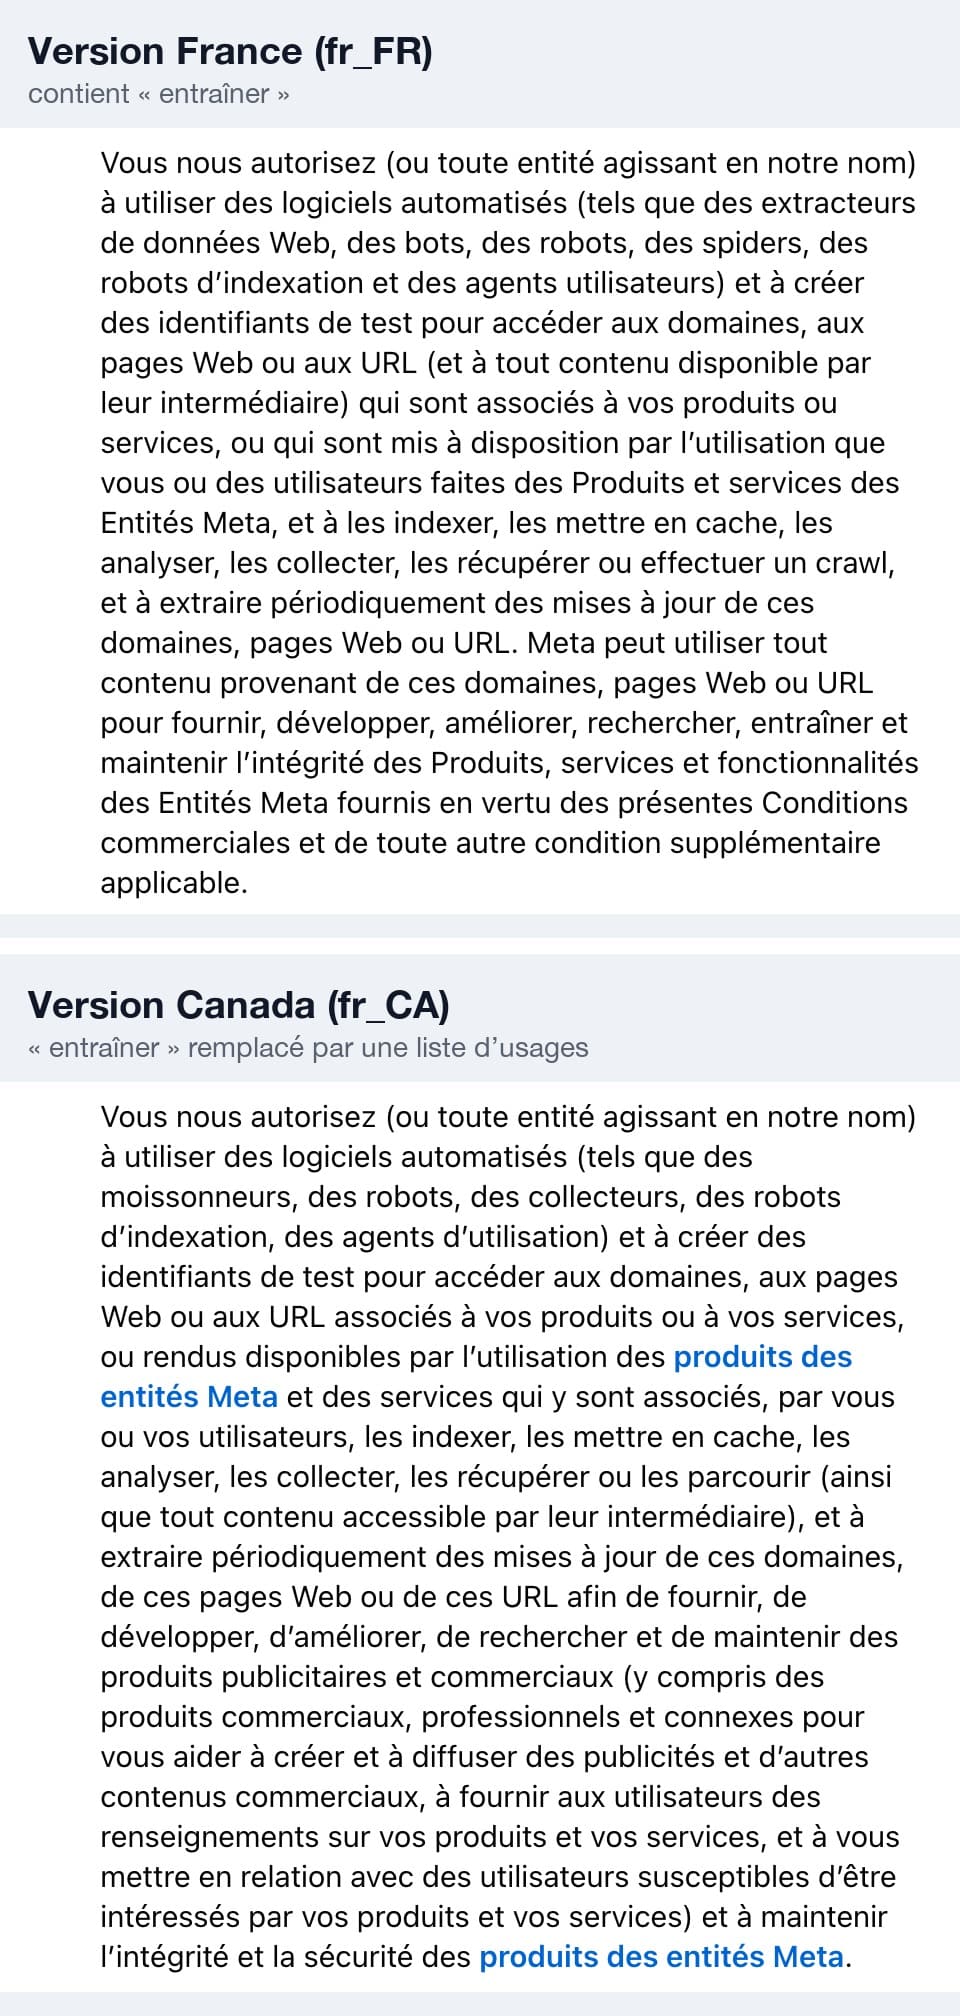
La clause, version par version
- français (Canada)
- corrigé dès 10 h 35 (19 oct.)
- anglais (États-Unis, Royaume-Uni)
- « train » à 10 h 35, corrigé à 15 h 40 (19 oct.)
- français (France)
- « entraîner » aux trois lectures du 19 oct. ; corrigé le 21 oct. à 9 h 08
- allemand
- « trainieren » aux trois lectures du 19 oct. ; corrigé le 21 oct. à 9 h 08
- italien
- « addestrare » aux trois lectures du 19 oct. ; corrigé le 21 oct. à 9 h 08
Notre lecture : le 19 oct., la correction avançait langue par langue et les trois versions inchangées étaient celles des trois principales langues nationales de la Suisse. Le 21 oct., les six versions sont corrigées. Reste ce que le texte corrigé permet encore, plus bas, et la page elle-même, que Meta peut modifier d’ici au 20 novembre. Le 27 octobre à 12 h 25 UTC, nous n’avons relu que la date : le 20 novembre partout, sauf en français (Canada), encore au 30 octobre. La clause, relue en anglais (États-Unis) et en français (France), n’a pas bougé depuis le 21 octobre ; la lecture des six versions n’est pas refaite.
En France, la presse a surtout retenu le retrait : « Meta fait marche arrière », titrait Siècle Digital le 19 octobre à 15 h 37, après KultureGeek la veille. À 15 h 40 UTC, soit deux heures plus tard à Paris, la version française de la page disait toujours « entraîner ».
Le site PPC Land avait fait le même constat sur la version britannique le 18 octobre.
Et même corrigé, le texte laisse Meta « développer » ses produits publicitaires et commerciaux avec ce contenu, un mot assez large, selon l’un des juristes, pour inclure l’entraînement.
robots.txt : ce que Meta promet, ce que le texte ne dit pas
Robots.txt est un petit fichier, à la racine d’un site, qui dit aux robots ce qu’ils peuvent visiter. Meta affirme qu’il reste respecté : la nouvelle clause ne lui donnerait « pas de nouveaux droits » qui passeraient par-dessus, a déclaré un porte-parole à Nieman Lab. Les conditions, elles, ne mentionnent pas robots.txt : Nieman Lab le constatait encore le 23 octobre, quand Meta a repoussé la date en répétant cette promesse. C’est toujours le cas le 27 en français et en anglais britannique.
Et robots.txt n’est qu’une préférence. Le respecter est volontaire, rappelle le professeur de droit Benjamin Sobel dans le même article. Sa propre documentation le confirme : deux robots de Meta peuvent passer outre.
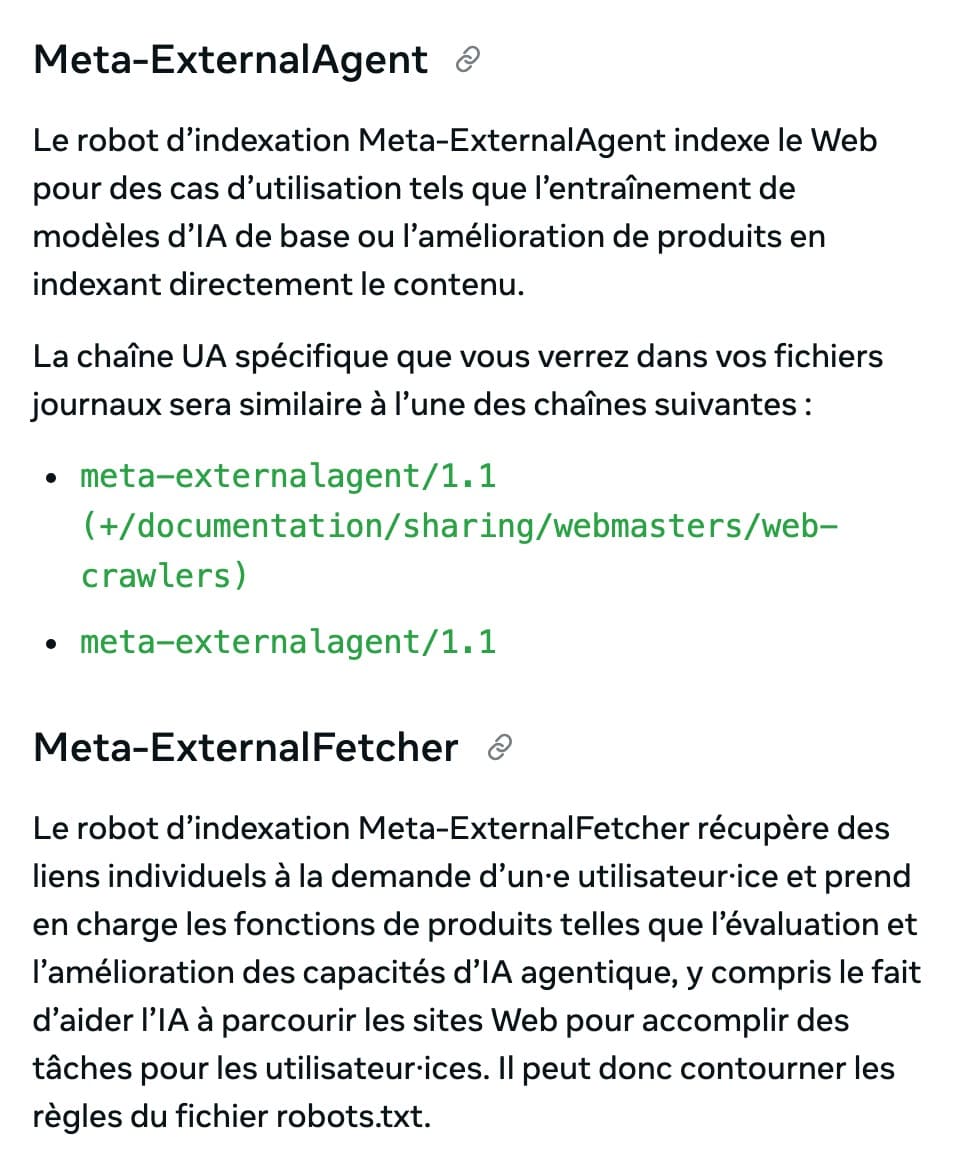
Les cinq robots de Meta, selon sa documentation
| Robot | À quoi il sert | robots.txt |
|---|---|---|
| FacebookExternalHit | Titre, description et image des liens partagés | Respecté, sauf contrôles de sécurité |
| Meta-WebIndexer | Réponses de Meta AI : citer et lier votre contenu | Respecté |
| Meta-ExternalAds | Améliorer les publicités et produits commerciaux | Respecté |
| Meta-ExternalAgent | Entraîner des modèles d’IA, indexer du contenu | Respecté |
| Meta-ExternalFetcher | Liens demandés par un utilisateur, tâches d’agents IA | Peut être contourné |
Ce que vous pouvez décider avant le 20 novembre
Commencez par l’inventaire : vos comptes professionnels, et les domaines qui y sont reliés par vos annonces, votre catalogue, votre pixel Meta ou votre Page. Ce sont eux que la clause vise.
Ensuite, trois choix réalistes. Ne rien changer, et accepter le texte tel qu’il vous sera appliqué. Ou bloquer le robot d’entraînement dans robots.txt et laisser passer les autres, en sachant qu’aucune ligne du contrat ne garantit l’effet de ce blocage.
Ou arrêter tout usage professionnel de Meta, ce qu’envisage sérieusement un éditeur interrogé par Nieman Lab.
Exemple : la boutique du début veut garder ses aperçus de liens et ses publicités, mais refuser l’entraînement. Deux lignes suffisent dans son fichier robots.txt.
User-agent: meta-externalagent
Disallow: /
Bloquer FacebookExternalHit, en revanche, priverait ses liens partagés de leur titre et de leur image. Une règle mal écrite peut aussi bloquer des robots utiles à votre visibilité : un fichier robots.txt se relit avec le reste de votre référencement, pas à la hâte la veille d’une échéance.
Ce qui reste incertain
Trois questions sont ouvertes au 19 octobre. Quelle version du texte s’appliquera hors des États-Unis. Ce que permettent exactement les « identifiants de test » : un juriste cité par Nieman Lab y voit un moyen de franchir une page d’inscription, et Meta n’a pas répondu sur ce point.
Et si un régulateur s’en saisit : le European Publishers Council a annoncé qu’il saisirait la Commission européenne. Depuis, des associations d’éditeurs ont écrit à Meta et à la Commission ; Meta a repoussé la date, la Commission a salué le report et l’autorité britannique de la concurrence (CMA) dit continuer à examiner les conditions (Nieman Lab, Digiday, 26 octobre ; PPC Land, 23 octobre).
Notre lecture : pour une entreprise qui dépend de Meta pour vendre, quitter ses outils n’est pas une option réaliste, et la seule marge de manœuvre est technique et partielle. À surveiller d’ici au 20 novembre : la page des conditions elle-même, que Meta peut encore modifier.
À retenir
- Dès le 20 novembre 2026 (Meta a repoussé la date du 30 octobre), utiliser Meta à des fins professionnelles vaut autorisation de parcourir les sites liés à vos produits et d’en utiliser le contenu.
- Meta a retiré le mot « entraîner » après les critiques, mais garde le droit de « développer » ses produits avec ce contenu ; le 19 octobre, la correction n’était pas encore visible en français.
- robots.txt permet de bloquer le robot d’entraînement de Meta, mais les conditions ne le mentionnent pas et deux robots peuvent passer outre.
- Il n’existe pas de retrait partiel : refuser le texte, c’est cesser tout usage professionnel de Facebook, Instagram et WhatsApp.
Ce que nous ne savons pas
Cet article lit des textes ; il ne mesure pas ce que font les robots de Meta sur un site.
La lecture des six versions date du 19 octobre 2026, à trois heures précises ; Meta corrige ses versions une à une et elles peuvent changer d’ici au 20 novembre.
Les déclarations de Meta sont rapportées par Nieman Lab et Digiday ; Meta n’a publié aucune note datée sur sa correction. Ce texte n’est pas un conseil juridique : pour un cas précis, demandez l’avis d’un juriste.
Sources
11 sources vérifiées3 officielles ou institutionnelles
- MetaConditions commerciales de Meta — version en vigueur avant les nouvelles conditionsNon daté — consulté le
- Meta for DevelopersRobots d’indexation de Meta (documentation pour les webmasters)Non daté — consulté le
- Nieman LabMeta’s new commercial terms will allow the scraping of news sites, legal experts say · consulté le
- Siècle DigitalMeta fait marche arrière sur l’utilisation des contenus des sites web pour entraîner son IA · consulté le
- DigidayMeta delays rollout of updated commercial terms amid publishers’ collective pushback · consulté le
Comment cet article a été produit Recherche et rédaction réalisées avec l’aide d’une IA (Claude), selon la méthode éditoriale d’EMA. L’aperçu des conditions de Meta a été lu le 19 octobre 2026 dans six versions, à 10 h 35, 15 h 40 et 22 h 18 UTC, et capturé, comme les conditions en vigueur et la documentation des robots ; les deux reportages de Nieman Lab ont été lus en entier. La date d’entrée en vigueur a été relue le 27 octobre 2026. Jhovany Mabiala signe l’article et en porte la responsabilité.
Besoin de clarifier votre stratégie SEO / GEO ? Voir notre expertise Référencement.