

Refuser l’IA de Google : ce que bloque chaque réglage
Robots.txt, Google-Extended, le bouton de la Search Console : chacun ferme une porte différente. Google vient de rappeler les limites du premier.
Par Jhovany Mabiala
CEO, EMA DigitalPublié le

Beaucoup de sites pensent avoir « bloqué l’IA » avec une ligne dans leur fichier robots.txt.
Le 21 octobre, dans une vidéo de Google Search Central, Gary Illyes en a rappelé la limite : ce fichier « ne dicte pas ce qu’un système fait des données après les avoir explorées », selon Search Engine Roundtable ; PPC Land rapporte la même phrase (traduit).
Google propose en fait trois réglages, et chacun ferme une porte différente. Nous les avons mis côte à côte, d’après les pages de Google, et passé quatorze fichiers robots.txt dans l’analyseur open source de Google, le programme qu’il publie pour lire ces fichiers.
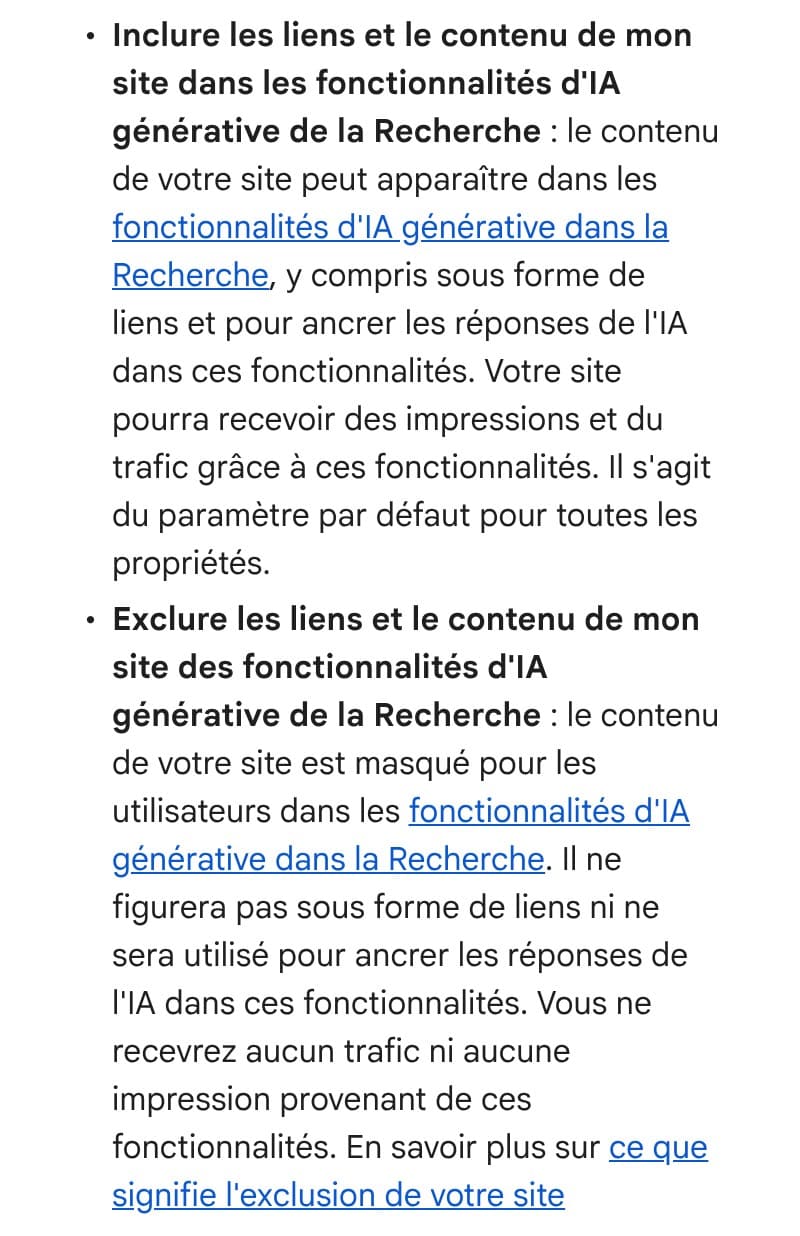
Le plus récent, le bouton de la Search Console, est ouvert à tous les sites depuis le 31 août 2026. Il propose d’inclure votre site, le réglage par défaut, ou de l’exclure.
- Qui est concerné
- Toute entreprise dont le site est visible dans Google et qui veut choisir ce que l’IA de Google fait de son contenu.
- Ce que cela change pour votre entreprise
- Sortir des Aperçus IA coupe le trafic qui en vient ; bloquer Googlebot arrête aussi l’exploration pour la recherche.
- Que faire
- Nommez ce que vous refusez — l’entraînement, les réponses IA ou l’exploration —, puis choisissez le réglage qui y correspond.
Réponse courteLa réponse en quelques lignes
Aucun réglage ne « bloque l’IA » en entier. Robots.txt dit aux robots de Google où ils peuvent aller. Google-Extended refuse que votre contenu serve à entraîner les futurs modèles Gemini, l’IA de Google, et à ancrer leurs réponses, sans toucher la recherche. Le contrôle de la Search Console retire votre site des Aperçus IA et du Mode IA, sans effet sur l’entraînement.
SommaireRobots.txt ferme une porte, il ne fixe pas l’usage
Robots.txt ferme une porte, il ne fixe pas l’usage
Robots.txt est un petit fichier, à la racine d’un site, qui dit aux robots quelles adresses ils peuvent visiter. Google le décrit d’abord comme un moyen d’« éviter de surcharger votre site de demandes ».
Il « ne sert pas à empêcher qu’une page Web figure dans les résultats de recherche Google » : pour cela, il faut la balise noindex, une consigne de ne pas lister la page (introduction à robots.txt).
Une règle Disallow (« interdire ») veut dire « n’entrez pas dans la pièce », et rien de plus, a résumé Gary Illyes selon Search Engine Roundtable. Pour écarter un robot d’IA précis, il faut viser son nom exact, rapporte PPC Land.
Notre lecture : robots.txt est une porte, pas un contrat. Et la fermer à Googlebot, le robot de la recherche, vous retire aussi de l’exploration pour la recherche.
Google-Extended : refuser l’entraînement, rester dans Google
Google-Extended n’est pas un robot de plus : c’est un nom réservé, que vous écrivez après « User-agent » dans robots.txt. Les robots habituels de Google font l’exploration ; ce nom sert de réglage.
Il décide si votre contenu peut servir à « entraîner les futures générations de modèles Gemini », l’IA de Google, et à l’ancrage, c’est-à-dire nourrir leurs réponses avec des pages de la recherche.
Il « n’a aucune incidence sur l’inclusion d’un site dans la recherche Google et n’est pas utilisé comme signal de classement dans celle-ci » (documentation de Google, 20 octobre). Google ne précise pas ce qu’il advient des modèles déjà entraînés.
Le bouton de la Search Console : sortir des réponses IA, pas de l’entraînement
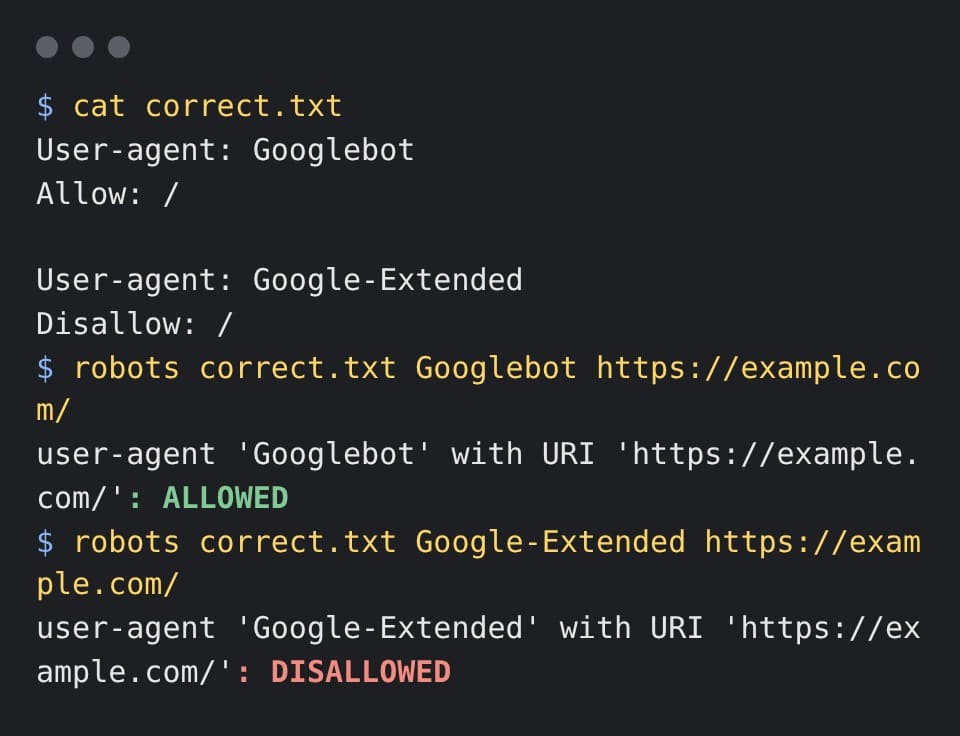
Le troisième réglage est dans la Search Console, l’outil gratuit de Google pour les propriétaires de sites : Paramètres, puis « IA générative dans la Recherche ». Il couvre les Aperçus IA (le résumé en tête des résultats), le Mode IA (les réponses conversationnelles) et les fonctions d’IA générative de Discover (aide de la Search Console).
Exclure son site, c’est disparaître de ces réponses, comme lien et comme contenu servant à les ancrer. Mais « le contenu d’autres sites restera disponible dans ces fonctionnalités et pourra ressembler au vôtre ». L’effet prend un à deux jours, parfois plus.
Ce bouton « n’est pas utilisé comme signal de classement ou d’inclusion dans les autres parties de la Recherche ». Votre contenu peut toujours servir à « alimenter la Recherche Google dans son ensemble ». Et « ce paramètre n’a pas d’incidence sur l’entraînement de l’IA » : pour cela, l’aide renvoie elle-même à Google-Extended.
Les trois réglages, côte à côte
Ce que chaque réglage bloque, selon Google
| Réglage | Ce qu’il bloque | Ce qu’il ne bloque pas | Ce qu’il coûte |
|---|---|---|---|
| robots.txt (Googlebot) | L’exploration des adresses visées | L’affichage d’une adresse connue, sans description | L’exploration pour la recherche |
| robots.txt (Google-Extended) | Entraînement et ancrage de Gemini | La recherche, le classement | Rien dans la recherche, selon Google |
| Search Console, « Exclure » | Aperçus IA, Mode IA, IA de Discover | L’entraînement, « la Recherche dans son ensemble » | Le trafic de ces réponses |
Les lignes « anti-IA » qui ne bloquent rien
Google ne lit que quatre champs, user-agent, allow, disallow et sitemap, et « ignore les lignes non valides » (spécification de robots.txt). Dans notre test, aucune erreur ne s’affiche : la ligne est ignorée en silence.
Une directive inventée, « NoAI », ne bloque rien. Un nom mal écrit, « GoogleExtended » sans tiret ou « Google Extended » avec une espace, ne vise personne. « Crawl-delay » n’est pas pris en charge par Google.
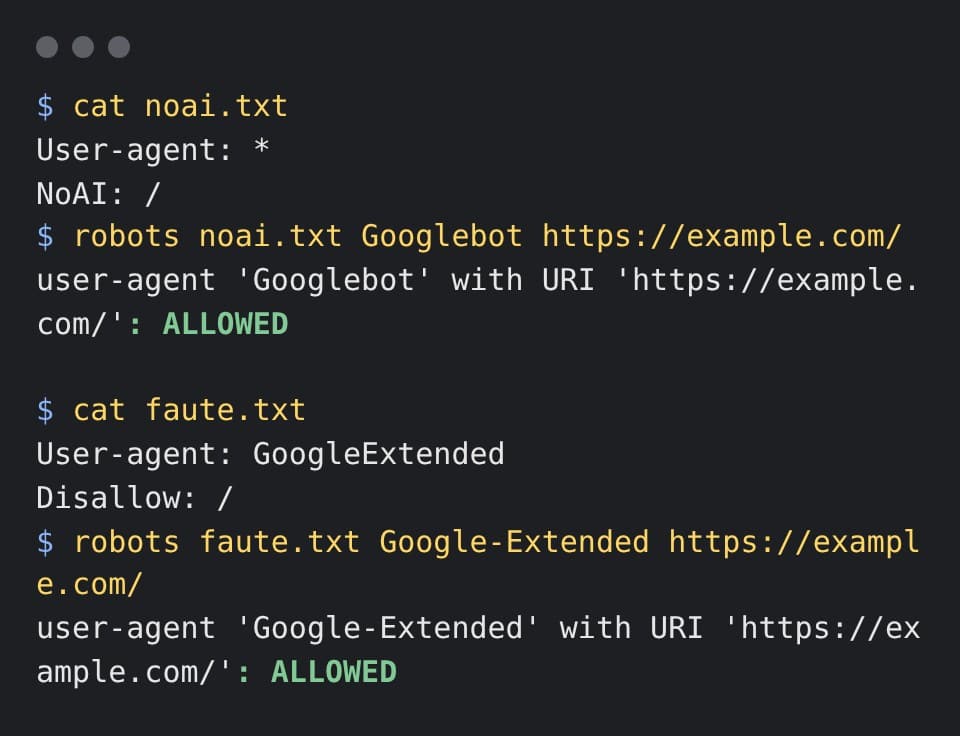
Il tolère en revanche « Dissallow » ou un deux-points oublié. Rien ne dit que les autres robots en font autant : écrivez sans faute.
Méthode. Quatorze fichiers robots.txt passés dans l’analyseur de Google (commit 22b355f du 1er avril 2026) le 24 octobre 2026, heure de Zurich, puis relancés le même matin : même résultat. Il couvre la lecture des règles, pas la logique de chaque robot ni les données déjà collectées.
Par où commencer
Mesurez d’abord : le rapport de la Search Console consacré à l’IA générative montre où votre site apparaît déjà dans ces réponses (Google, 3 juin 2026). C’est ce qu’une exclusion toucherait.
Ensuite, une question à la fois. Refuser l’entraînement et l’ancrage de Gemini : Google-Extended, sans effet sur la recherche selon Google. Ne pas nourrir les Aperçus IA : le bouton de la Search Console, au prix de ce trafic. Un « Disallow: / » pour tous les robots ferme aussi la recherche.
Enfin, relisez chaque ligne : le nom exact du robot, le deux-points. Un fichier robots.txt se relit avec le reste de votre référencement : une règle trop large coupe aussi ce qui vous rend visible.
À retenir
- Robots.txt règle l’accès des robots, pas l’usage de ce qu’ils ont déjà collecté, a rappelé Google le 21 octobre 2026 (vidéo rapportée par Search Engine Roundtable et PPC Land).
- Google-Extended refuse l’entraînement des futurs modèles Gemini et l’ancrage de leurs réponses, sans effet sur la recherche Google, selon sa documentation.
- Le contrôle de la Search Console retire un site des Aperçus IA, du Mode IA et des fonctions d’IA générative de Discover, avec le trafic qui en vient, mais ne touche pas l’entraînement.
- Une ligne inventée (« NoAI ») ou un nom mal écrit (« GoogleExtended ») ne bloque rien, sans erreur, dans l’analyseur de Google.
Ce que nous ne savons pas
Cet article décrit les réglages de Google d’après ses propres pages ; il ne mesure pas ce que fait un robot sur un site.
Le test porte sur l’analyseur open source de Google, qui couvre la lecture des règles, pas la logique de chaque robot ; d’autres robots peuvent lire un fichier autrement. L’écran du réglage n’a pas été observé dans une Search Console réelle. Les citations datent du 24 octobre 2026.
Sources
8 sources vérifiées6 officielles ou institutionnelles
- GoogleContrôle de l’IA générative dans la Recherche — Aide sur la Search ConsoleNon daté — consulté le
- Google Search Central BlogPrésentation des rapports sur les performances dans l’IA générative dans la Recherche de la Search Console · consulté le
- Google (open source)google/robotstxt — analyseur et outil de correspondance robots.txt de Google (commit 22b355f) · consulté le
- Search Engine RoundtableGoogle On robots.txt Rules For AI Crawlers, Emojis, International URLs & More · consulté le
Comment cet article a été produit Recherche et rédaction réalisées avec l’aide d’une IA (Claude), selon la méthode éditoriale d’EMA. Les pages de Google ont été lues en français le 24 octobre 2026 ; la vidéo du 21 octobre, inaccessible depuis notre environnement, est citée d’après Search Engine Roundtable et PPC Land, qui la transcrivent (PPC Land d’après les sous-titres automatiques). Le test de l’analyseur a été exécuté le 24 octobre puis relancé le même matin ; sa méthode est publiée. Jhovany Mabiala signe l’article et en porte la responsabilité.